Hugging Face、エージェント性能を独自ツールで評価するベンチマーク手法を公開
AIエージェントの評価指標として、最終回答だけでなく推論プロセス全体を計測する手法が提案されました。transformersライブラリを例にした検証では、モデルがライブラリをバイパスしてロジックを再…
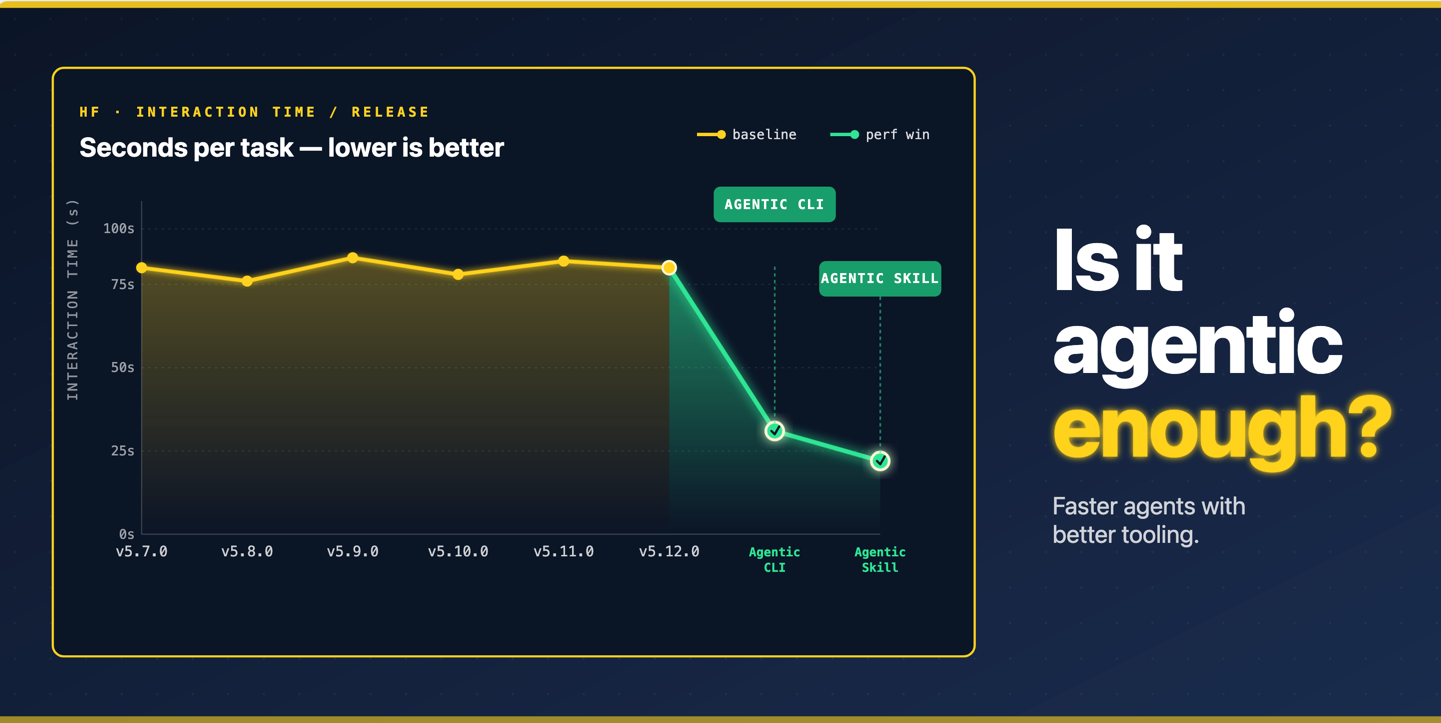
Hugging Faceは、AIエージェントが独自の開発ツールやライブラリをどの程度使いこなせているかを評価する新しいベンチマーク手法を公開しました。従来の評価は最終的な回答の正誤のみを重視していましたが、本手法ではエージェントがタスクを完了するまでのステップ数やデバッグの回数、特定ライブラリの呼び出し方といった実行プロセス全体を可視化します。
検証の結果、エージェントはライブラリの利用が困難だと判断した場合、既存の関数を使わず独自にロジックを書き直す挙動を示すことが確認されました。これはモデルの規模やライブラリのバージョンによって変化し、大規模モデルではリビジョン間の差異が、小規模モデルではモデル間の性能差が顕著に現れる傾向があります。
独自のCLIやライブラリをエージェントに操作させる場合、単に機能を提供しただけでは不十分であり、エージェントが意図した通りにツールを選択・実行できるかを確認するプロセスが必要です。開発者は、本手法を用いることで自社ツールの「エージェント親和性」を客観的な数値で把握できるようになります。
この記事は役に立ちましたか?